Un día deja de funcionar el correo electrónico de miles de empresas. Al siguiente, una falla informática obliga a detener vuelos en Estados Unidos. Después aparecen problemas en bancos, aerolíneas y servicios de Apple. En cuestión de días, sistemas que millones de personas consideran indispensables han demostrado que también pueden dejar de responder. La sucesión de incidentes registrados entre el 12 y el 17 de noviembre de 2026 plantea una pregunta inevitable: ¿qué está pasando con la infraestructura tecnológica de la que depende buena parte de nuestra vida cotidiana? La respuesta no es tan espectacular como una conspiración informática, pero probablemente sea más preocupante.
Los informes disponibles apuntan a errores de software, problemas de comunicaciones, sobrecarga de servidores y fallas en sistemas internos. No existe evidencia pública de que todos estos episodios formen parte de un mismo ataque o tengan una causa común.
Sin embargo, al examinar los incidentes aparece un problema de fondo: hemos construido servicios extremadamente complejos en los que una avería localizada puede desencadenar consecuencias desproporcionadas.
De Microsoft a Apple: seis días que expusieron la fragilidad digital
La cadena de interrupciones comenzó a llamar la atención el 12 de noviembre, cuando Microsoft 365 sufrió una falla que afectó especialmente a Exchange Online y Outlook. También se vieron perjudicadas funciones de Teams, Copilot y otras herramientas empresariales.
El 13 de noviembre, la Administración Federal de Aviación de Estados Unidos (FAA) ordenó detener temporalmente las salidas de vuelos en todo el país debido a problemas en su infraestructura de telecomunicaciones.


El 15 de noviembre, Amazon Web Services notificó dificultades de conectividad y autenticación en su región de Virginia del Norte, conocida como US-EAST-1.
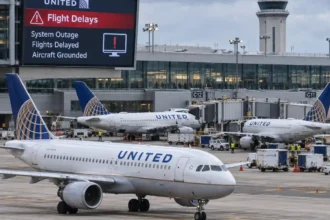
El lunes 16 llegaron otros dos incidentes. JPMorgan Chase experimentó retrasos en el procesamiento de transacciones bancarias, mientras United Airlines tuvo que demorar vuelos por problemas en sus sistemas informáticos.
El martes 17, Apple reconoció interrupciones en servicios como App Store, Apple Music, AppleCare y el acceso a cuentas de iCloud.
La proximidad de estos acontecimientos explica la inquietud. Pero una coincidencia temporal no demuestra que los problemas estén relacionados.
Microsoft: cómo un error oculto terminó saturando sus servidores
El caso de Microsoft permite entender uno de los peligros menos visibles de los grandes sistemas digitales.
Según sus comunicaciones técnicas posteriores al incidente, un defecto de software que ya existía en su infraestructura quedó expuesto cuando se produjeron cambios en la distribución del tráfico de red.
Parte de las solicitudes que recibían los servidores comenzó a acumularse en lugar de procesarse normalmente. La cola creció hasta consumir la capacidad disponible, impidiendo que nuevas conexiones fueran atendidas.
Es parecido a una autopista en la que un problema en una salida provoca una fila de vehículos. Si siguen llegando automóviles y nadie puede avanzar, el congestionamiento termina bloqueando también los accesos que funcionaban.
En sistemas como Microsoft 365, ese embotellamiento puede impedir que una empresa consulte su correo, que un empleado acceda a su calendario o que determinadas herramientas recuperen información necesaria para funcionar.
Microsoft señaló que el incidente fue técnico y que no encontró indicios de un ciberataque ni de acciones realizadas por agentes de inteligencia artificial.
La recuperación tampoco fue inmediata. Una vez corregido el problema, los equipos tuvieron que restablecer progresivamente los servicios y procesar los mensajes acumulados.
La lección es incómoda: corregir el error que provocó una caída no significa que todos los servicios vuelvan a funcionar instantáneamente.
La FAA: cómo un problema de comunicaciones terminó afectando vuelos de todo un país
El incidente de la aviación estadounidense muestra otra clase de vulnerabilidad.
En su informe publicado el 15 de noviembre, la FAA explicó que sus equipos comenzaron a recibir un volumen anormal de tráfico: aproximadamente 1.000 intentos de conexión cada cuatro o cinco segundos.
Esa actividad desestabilizó una red de telecomunicaciones que todavía utiliza componentes antiguos. La interrupción afectó a 17 de los 22 centros regionales de control de tráfico aéreo del país.
La investigación identificó dos posibles puntos de origen del tráfico anormal, uno en Texas y otro en Arkansas. En este último se habían realizado trabajos que incluían la instalación de un nuevo router.
La agencia aisló las conexiones problemáticas y desactivó preventivamente determinadas funciones en otros equipos. También suspendió nuevas instalaciones mientras continúa la investigación.
Lo importante es entender que no se trató de que todos los radares dejaran de funcionar simultáneamente.
La FAA indicó que algunas comunicaciones y señales permanecieron operativas. Sin embargo, la inestabilidad general obligó a detener temporalmente los despegues por seguridad.
El episodio demuestra que una red puede conservar parte de sus capacidades y, aun así, dejar de ofrecer la confiabilidad necesaria para una actividad crítica.
Los bancos y las aerolíneas también dependen de sistemas invisibles
El 16 de noviembre, JPMorgan Chase atribuyó sus problemas al funcionamiento incorrecto de software instalado en sistemas internos.
La falla provocó retrasos en el procesamiento de operaciones. Como las instituciones financieras intercambian transacciones, los efectos podían alcanzar también a clientes de otros bancos sin que sus respectivas plataformas estuvieran necesariamente averiadas.
Esta distinción es fundamental.
Que una transferencia entre dos bancos no llegue a tiempo no demuestra que ambos bancos hayan sufrido una caída. El problema puede encontrarse en uno de los participantes o en algún servicio intermediario.
Ese mismo día, United Airlines enfrentó una interrupción tecnológica que retrasó durante más de 90 minutos las salidas de sus vuelos.
Los reportes de los pilotos señalaron dificultades para obtener los datos finales de peso y balance de las aeronaves, información indispensable para calcular las condiciones de despegue.
Un avión puede tener combustible, tripulación y pasajeros listos. Pero si no se dispone de los datos necesarios para realizar una operación segura, debe permanecer en tierra.
United indicó que no encontró señales de un incidente de ciberseguridad. Tampoco se estableció una relación causal con la falla de la FAA ocurrida tres días antes.
La nube tiene respaldos, pero también puntos débiles
Otro error frecuente consiste en pensar que almacenar información en la nube elimina el riesgo de interrupciones.
La nube no es un lugar abstracto. Detrás de cada servicio existen centros de datos, equipos de comunicaciones, instalaciones eléctricas y programas que coordinan millones de operaciones.
Amazon Web Services informó que el 15 de noviembre experimentó problemas de autenticación y conectividad en su región US-EAST-1. La situación afectó a determinados servicios y clientes, aunque no significó una caída mundial de toda la plataforma.
Un episodio anterior ayuda a comprender que los respaldos tampoco son infalibles.
El 20 de octubre, un centro de datos de Google Cloud en Londres sufrió una interrupción eléctrica. Los generadores de emergencia no asumieron automáticamente la carga debido a un problema en la lógica de control.
Las baterías mantuvieron los equipos funcionando durante unos minutos. Cuando se agotaron, parte de la infraestructura quedó sin energía.
Google explicó que el intento de trasladar operaciones a otras zonas disponibles también produjo congestión y retrasos.
Aquí aparece una de las grandes paradojas de la infraestructura digital: un sistema de respaldo puede existir y estar instalado correctamente, pero fallar cuando realmente se necesita.
La redundancia no consiste solamente en duplicar equipos. También exige comprobar que los mecanismos de recuperación funcionan en situaciones reales y que no comparten las mismas debilidades.
¿Estamos ante una ola de ciberataques o errores provocados por inteligencia artificial?
Las interrupciones consecutivas han alimentado sospechas sobre ataques coordinados, sabotaje e incluso sistemas de inteligencia artificial actuando fuera de control.
Pero los datos conocidos no permiten sostener esas explicaciones.
Microsoft, la FAA, JPMorgan Chase y United Airlines comunicaron que no encontraron indicios de ataques informáticos en los incidentes mencionados. En otros casos, como las interrupciones de Apple, la información pública disponible no permite establecer con el mismo detalle la causa técnica definitiva.
Eso no significa que los ciberataques hayan dejado de ser una amenaza. Significa que una interrupción tecnológica y un ataque informático no son lo mismo.
Los errores de programación, las configuraciones incorrectas, la saturación de recursos y las fallas físicas pueden producir consecuencias muy graves sin intervención de delincuentes.
También conviene evitar otra conclusión precipitada: que las actualizaciones de seguridad estén provocando todas estas interrupciones. Algunos incidentes involucraron cambios técnicos, pero eso no demuestra que se tratara de parches de seguridad ni permite establecer una causa común.
Actualizar sistemas sigue siendo fundamental para protegerlos. El desafío consiste en hacerlo con pruebas, supervisión y mecanismos que permitan revertir cambios problemáticos.
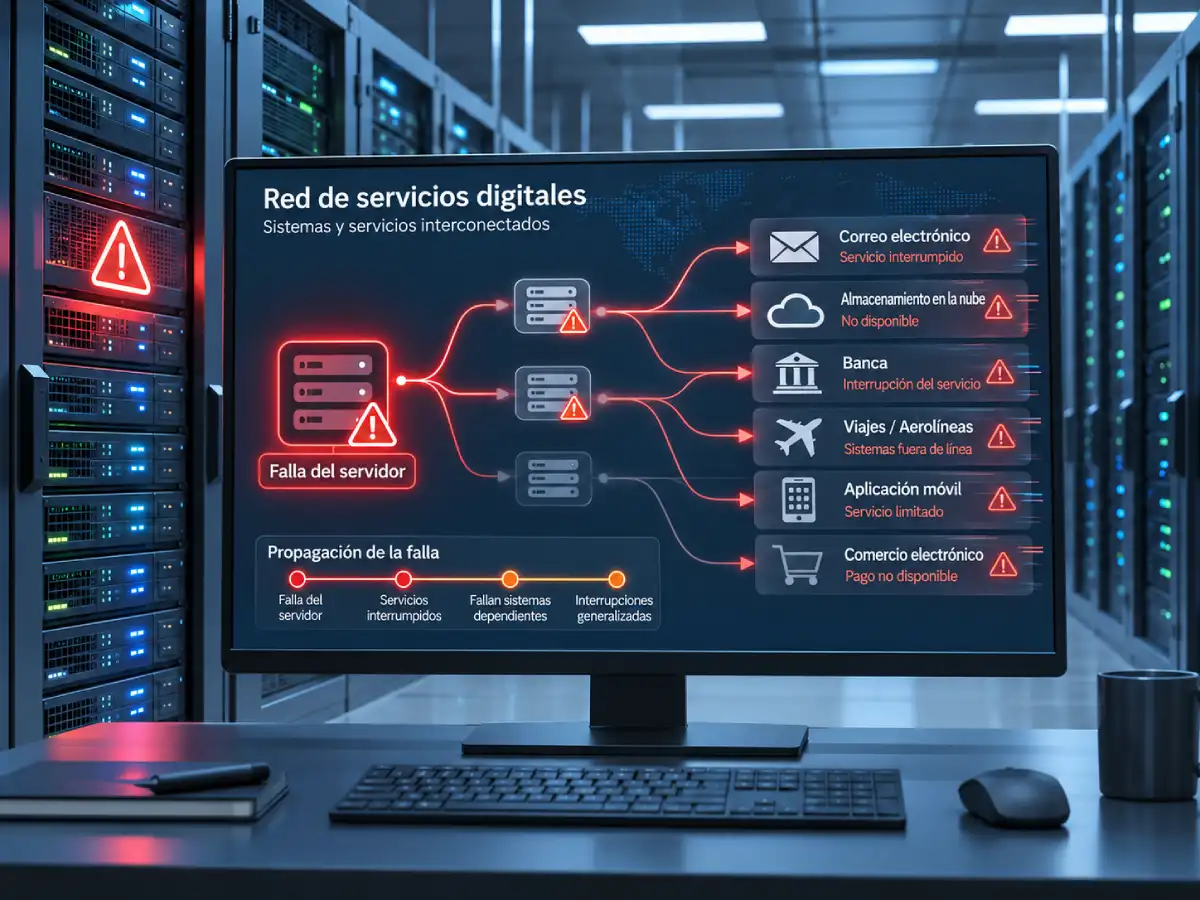
El verdadero problema es el efecto dominó
Los grandes servicios digitales no funcionan de manera aislada.
Una aplicación depende de servidores. Los servidores necesitan redes, energía, bases de datos y sistemas de identificación. Esos componentes pueden depender, a su vez, de proveedores externos.
Cuando uno falla, otros servicios pueden perder funciones aunque sus propios equipos sigan trabajando correctamente.
Los especialistas en confiabilidad de Google describen este fenómeno como una falla en cascada: un problema inicial genera sobrecarga en otros componentes, que también comienzan a fallar.
Por ejemplo, cuando un servidor no responde, otros sistemas pueden intentar conectarse repetidamente. Esos nuevos intentos generan todavía más tráfico sobre una infraestructura que ya está saturada.
La tecnología diseñada para recuperarse automáticamente puede terminar agravando el problema si no existen límites adecuados.
Ahora bien, hay algo que todavía no sabemos: si estos incidentes representan un aumento sostenido de las interrupciones tecnológicas o simplemente una concentración excepcional de fallas muy visibles.
Para afirmarlo harían falta estadísticas comparables de distintos años, servicios y proveedores. Contar las noticias de una semana no basta.
Qué pueden hacer los usuarios y las empresas cuando falla un servicio
Para una persona común, la medida más importante es no depender de una sola vía para realizar actividades esenciales.
Conviene disponer de alternativas de pago, conservar copias accesibles de documentos importantes y comprobar el estado oficial de un servicio antes de reinstalar aplicaciones o modificar contraseñas.
Si una transferencia bancaria presenta errores, repetirla varias veces sin verificar su estado puede generar confusión o incluso operaciones duplicadas.
Para los negocios, las consecuencias pueden ser mayores. Una empresa que depende exclusivamente de una aplicación para vender, atender clientes, consultar inventarios o comunicarse puede quedar parcialmente paralizada aunque tenga electricidad y conexión a Internet.
Por eso resulta necesario identificar qué operaciones pueden continuar sin conexión, mantener respaldos verificables y establecer procedimientos sencillos para atender al público cuando fallen los sistemas principales.
En servicios críticos, distribuir funciones entre proveedores o regiones puede reducir riesgos, siempre que esa independencia sea real y los mecanismos alternativos hayan sido probados.
Las grandes compañías tecnológicas también tienen una responsabilidad que no puede trasladarse al usuario: diseñar plataformas capaces de contener errores, publicar explicaciones verificables de los incidentes y demostrar que las medidas correctivas funcionan.
La conclusión de esta semana no es que Internet esté a punto de desaparecer ni que alguien haya tomado el control de sus sistemas.
Es algo más concreto: nuestra dependencia de la tecnología ha crecido hasta un punto en el que una avería de pocos componentes puede interrumpir actividades esenciales de millones de personas.
Y cuanto más indispensable se vuelve un servicio digital, menos aceptable resulta que su capacidad de recuperación dependa de mecanismos que nunca fueron suficientemente probados.